

LLM
Como entender LLMs por dentro: trilha de livros
Uma trilha que combina os repositórios gratuitos de Andrej Karpathy (micrograd, nanoGPT e nanochat) com três livros para entender um LLM por dentro.
Atualizado em · Equipe Estante Dev
Este guia propõe uma trilha para entender como um modelo de linguagem grande funciona por dentro, do gradiente ao chat. A trilha alterna código e leitura. O código vem de três repositórios gratuitos de Andrej Karpathy no GitHub. A leitura vem de três livros do catálogo.
Cada etapa usa o que a anterior explicou.
Por que começar pelo código pequeno
Os repositórios de Karpathy têm uma característica em comum: são curtos o bastante para ler inteiros, e dá para ver cada operação acontecer sem tratar uma biblioteca grande como caixa-preta.
Os livros cobrem o que o código não explica sozinho: por que a retropropagação funciona, de onde vem a atenção, como se avalia um modelo e como ele é usado na prática.
Etapa 1: micrograd e os fundamentos
O micrograd é, segundo o README, um motor de autograd minúsculo, com uma pequena biblioteca de redes neurais por cima e API parecida com a do PyTorch. Os dois juntos somam cerca de 100 e 50 linhas. O motor implementa retropropagação (autodiferenciação em modo reverso) sobre um grafo montado durante a execução, operando só com escalares. Mesmo assim, o notebook de demonstração treina um MLP com duas camadas ocultas para classificação binária.
O par de leitura é Deep Learning, de Ian Goodfellow, Yoshua Bengio e Aaron Courville. A Parte I cobre a matemática de base, com álgebra linear, probabilidade e computação numérica (onde entra a otimização por gradiente). O capítulo 6, Deep Feedforward Networks, traz a seção sobre retropropagação e a regra da cadeia que o micrograd implementa em código. O livro tem uma versão on-line gratuita mantida pelos autores.
Uma sugestão prática é ler a seção sobre retropropagação do capítulo 6 e, em seguida, refazer à mão o cálculo de um gradiente que o micrograd devolve. Quando os dois números batem, a etapa está concluída.
Etapa 2: nanoGPT e o transformer
O nanoGPT treina e ajusta GPTs de tamanho médio. Segundo o README, o train.py tem cerca de 300 linhas de laço de treino e o model.py cerca de 300 linhas com a definição do modelo. O início rápido treina um GPT de caracteres com as obras de Shakespeare.
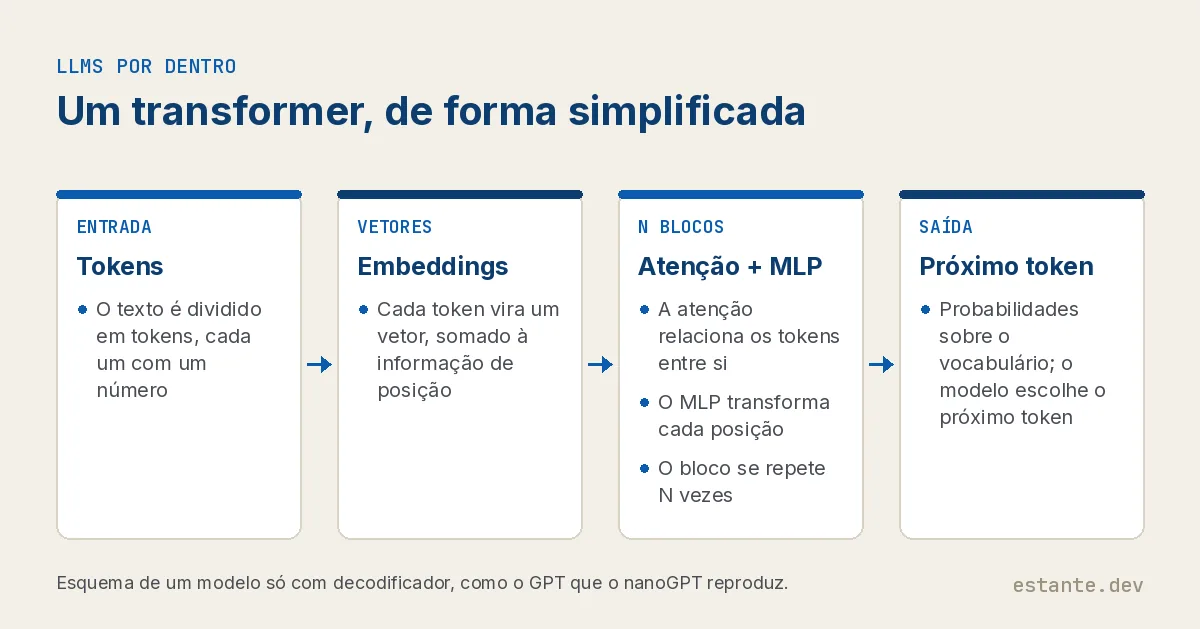
Há um aviso no topo do repositório. Desde novembro de 2025, Karpathy considera o nanoGPT antigo e descontinuado, e indica o nanochat. O código continua no ar e segue útil para estudo, porque o modelo cabe em um arquivo. Para quem prefere ver a construção passo a passo, o repositório build-nanogpt refaz o nanoGPT do zero, com commits organizados em sequência e uma aula em vídeo que acompanha cada um.
O par de leitura é Build a Large Language Model (From Scratch), de Sebastian Raschka. O livro constrói um modelo no estilo GPT em PyTorch. Os capítulos seguem a ordem do trabalho: preparar o texto, programar os mecanismos de atenção, implementar o GPT, pré-treinar com dados sem rótulo e ajustar o modelo para classificação de texto e para seguir instruções. Um apêndice trata de ajuste fino com LoRA. Lido ao lado do nanoGPT, ele dá duas implementações do mesmo desenho para comparar.
Etapa 3: nanochat e o ciclo completo
O nanochat é descrito no README como o arcabouço experimental mais simples para treinar LLMs. Ele roda em um único nó de GPU e cobre as etapas principais: tokenização, pré-treino, ajuste fino, avaliação e inferência. O README dá um exemplo de custo. Um modelo com capacidade de GPT-2, que custou cerca de 43 mil dólares para treinar em 2019, sai por 48 dólares em cerca de duas horas num nó com 8 GPUs H100. Ao fim, é possível conversar com ele por linha de comando.
Rodar o treino inteiro não é obrigatório. Ler o código de cada etapa já mostra o caminho de um texto bruto até um assistente que responde perguntas.
O par de leitura é Hands-On Large Language Models, de Jay Alammar e Maarten Grootendorst. O livro é visual e aplicado. Começa por tokens e embeddings e por um capítulo que abre o transformer por dentro. Depois passa a usos como classificação, agrupamento de textos, engenharia de prompt, busca semântica com RAG e modelos multimodais, e termina com a criação de modelos de embedding e o ajuste fino de modelos de representação e de geração. Depois de treinar um modelo pequeno, ele ajuda a ligar o que foi visto por dentro ao que se faz com modelos prontos. O repositório oficial do livro traz os notebooks dos capítulos.
A trilha resumida
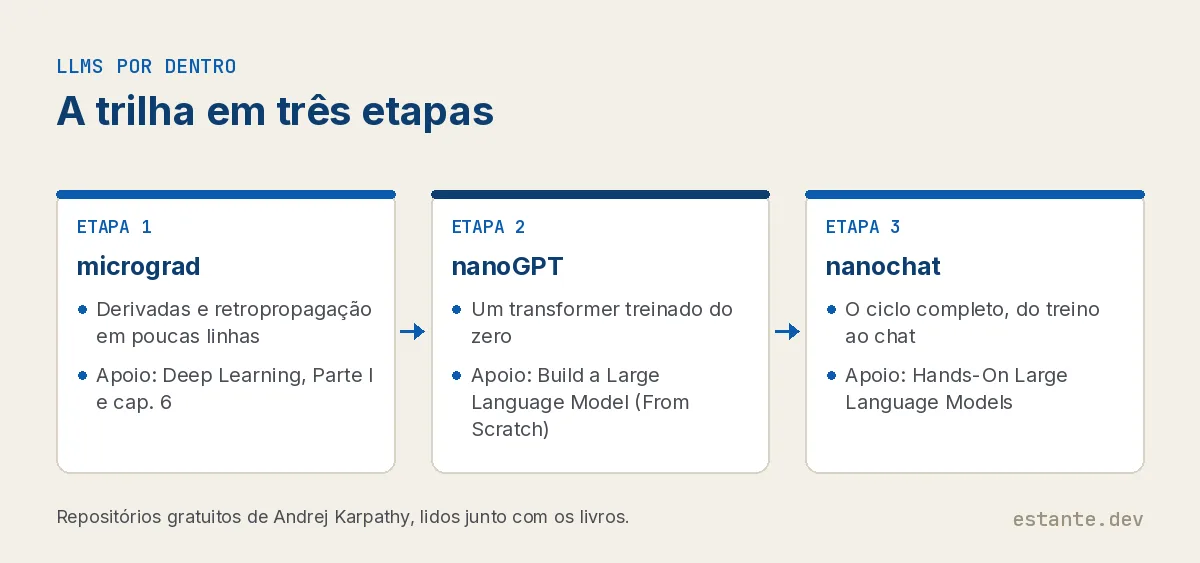
- micrograd com a Parte I e o capítulo 6 de Deep Learning.
- nanoGPT, ou build-nanogpt, com Build a Large Language Model (From Scratch).
- nanochat com Hands-On Large Language Models.
Quem já domina gradiente e redes simples pode começar na etapa 2. Quem só quer usar modelos prontos pode ir direto ao Hands-On Large Language Models, mas perde a parte que explica por que eles se comportam como se comportam.
Como associado da Amazon, eu ganho com compras qualificadas.
Fontes
- Karpathy, A. micrograd. GitHub. https://github.com/karpathy/micrograd
- Karpathy, A. nanoGPT. GitHub. https://github.com/karpathy/nanoGPT
- Karpathy, A. build-nanogpt. GitHub. https://github.com/karpathy/build-nanogpt
- Karpathy, A. nanochat. GitHub. https://github.com/karpathy/nanochat
- Goodfellow, I., Bengio, Y. e Courville, A. Deep Learning. MIT Press, 2016. https://www.deeplearningbook.org/
- Raschka, S. Build a Large Language Model (From Scratch). Manning, 2024. https://www.manning.com/books/build-a-large-language-model-from-scratch
- Alammar, J. e Grootendorst, M. Hands-On Large Language Models. O’Reilly, 2024. https://github.com/HandsOnLLM/Hands-On-Large-Language-Models